Research & Breakthroughs
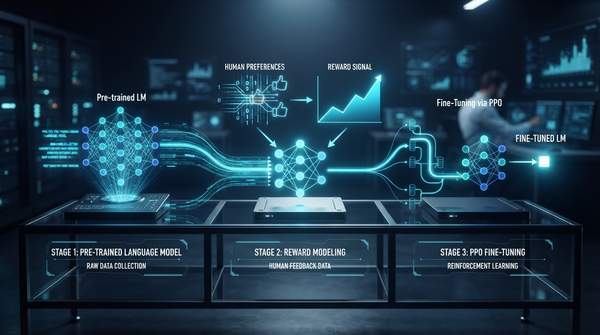
How RLHF Works: The Three-Stage Pipeline That Turns Human Preferences Into a Fine-Tuned Language Model
Reinforcement Learning from Human Feedback (RLHF) is a multi-stage pipeline that trains language models by incorporating human preferences. It involves supervised fine-tuning, training a reward model on human judgments, and then optimizing the language model using reinforcement learning.
David Katzman·November 6, 2026